
Data Formulator 工单分析:按类别比较等待时长,保留样本数与单位
按category统计工单数量和平均wait_minutes,输出表格与条形图。写明单位分钟,保留每类样本数,不能把平均等待解释为处理时长或客服绩效因果。 已真实读取原创CSV、独立Python重算并渲染数据结果;未调用Data Formulator模型。
阅读文章正在打开页面…
正在加载内容,请稍候。
388 篇教程,当前显示第 337–384 篇。选择页码继续浏览,或切换任务主题。
按category统计工单数量和平均wait_minutes,输出表格与条形图。写明单位分钟,保留每类样本数,不能把平均等待解释为处理时长或客服绩效因果。 已真实读取原创CSV、独立Python重算并渲染数据结果;未调用Data Formulator模型。
阅读文章
上传原创三章 EPUB,选择翻译服务与双语导出,再检查目录、阅读顺序、段落和电子书封装完整性。
阅读文章
从同一张虚构成人头像制作微笑、眨眼和中性三种静态素材,核对导出尺寸和人物身份。附可下载原创音视频、参数与检查脚本;输入预检和未执行模型步骤明确区分。
阅读文章
用Marp导出三页中文PDF。图片使用assets/device.svg,相对路径必须正确;长句不能溢出。开启PDF书签与备注,实际打开检查,不把命令退出0当作全部通过。 已运行Marp CLI 4.5.1生成基线与修正版PDF;已真实渲染固定版本的输出截图,未执行模型。
阅读文章
将五条提纲整理成五页Marp课件。每页一个主题,保留SL-08与缺充电线,不编造真实个人信息。添加页码、统一字体、讲者备注和最后练习答案。 已运行Marp CLI 4.5.1,实际生成HTML/PDF与页面截图;源稿人工编写,未执行AI模型。
阅读文章
用三条独立本地素材任务练习 JSONL 清单,先发现坏路径,再保存每个任务的真实执行记录。附可下载原创音视频、参数与检查脚本;输入预检和未执行模型步骤明确区分。
阅读文章
把同一底片预处理为 avatar,后续复用缓存处理三段不同旁白,保存每条任务与真实结果。附可下载原创音视频、参数与检查脚本;输入预检和未执行模型步骤明确区分。
阅读文章
为新手和志愿者各制作一份课程介绍,受众与页数按audiences.json。只使用60分钟、12台设备、4名志愿者。先为每个受众构造请求,记录真实任务ID,轮询至终态后再下载,失败保留原始错误。 已真实生成两份本地请求草稿并校验事实;未提交Presenton API,未产生真实任务ID或模型输出。
阅读文章
使用已创建的山岚模板生成三页社区工作坊介绍。只使用24、30、36三个报名数;保留页脚、主色和留白。不新增客户、收入或增长承诺。 已制作三页人工品牌源PPTX并检查结构;未在Presenton创建模板或运行模型。官方Template Studio截图用于识别真实入口。
阅读文章
把三组培训完成率做成条形图:安全入门30/40=75%,工具实践24/32=75%,团队协作10/20=50%。图表写明完成/报名与百分比,不能把30、24、10直接加百分号。 已用Python真实重算CSV并制作人工参考图表PPTX;未执行Presenton模型会话或编辑器操作。
阅读文章
制作3页中文社区课程介绍:面向新手、一次60分钟、练习材料免费;不新增价格或资质。先验证自定义provider可生成大纲,再生成演示。模型ID必须来自自己网关的实际可用模型。 已真实离线校验env字段和探测脚本参数;未连接外部API、未启动Presenton容器或调用模型。
阅读文章
把附件报告制作成6页简体中文演示:问题与决策、设备状态、借用分布、满意度、行动方案、待决事项。每个数字保留F编号;运行率18/24=75%,问卷满意率32/40=80%,不要把两者混为一谈。采购日期写待批准。 已生成并验证原创输入PDF及人工参考PPTX;未执行Presenton模型生成。
阅读文章
先用week-1.csv生成room/visits条形图并保存spec;再加载week-2.csv保留相同字段与图形配置。新一周东侧25、西侧35、中央50,总量110;不手工修改图上标签充当数据更新。
阅读文章
按device与day_type分组比较平均minutes,并显示每组n=2。四组均值:相机工作日30/周末60,投影工作日40/周末50。使用分面,不把8行数据说成8台设备。
阅读文章
读取facility.csv,day解释为日期,facility为分类,uses为数值。按日期和场地展示使用次数,先核对字段类型,不把字符串排序或count行数当sum使用次数。
阅读文章
把questions.json制作成三道Slidev小测。每题先显示题干,按下一步才显示答案;答案按原文件,不扩充统计结论。保留Markdown可编辑源文件。 已安装并运行锁定的Slidev 53.0.0;素材是人工编写、实际渲染的教学工程,没有执行AI模型会话。
阅读文章
做三步代码讲解:先固定输入,再展开reduce,最后给出totalCents函数。保持整数分单位,解释150*2+240=540分,不把540写成540元。 已安装并运行锁定的Slidev 53.0.0;素材是人工编写、实际渲染的教学工程,没有执行AI模型会话。
阅读文章
制作三页说明会演示,观众只看标题与要点,演讲者能看到每页备注和下一页。备注写在Markdown注释中,不直接放入正文。 已安装并运行锁定的Slidev 53.0.0;素材是人工编写、实际渲染的教学工程,没有执行AI模型会话。
阅读文章
生成本地Streamlit设备看板,上传CSV后验证device、temperature_c、status字段,温度>=60为教学异常阈值。提供阈值滑块、异常行表和CSV下载,不连接真实设备或发送告警。
阅读文章
创建可编辑排期表,三项hours默认2/3/1,容量8小时。用st.form提交后再重算;把小组实践改6应合计9超限1。输入负数、空名称或重复活动应拒绝。下载修改后CSV,原文件保持不变。
阅读文章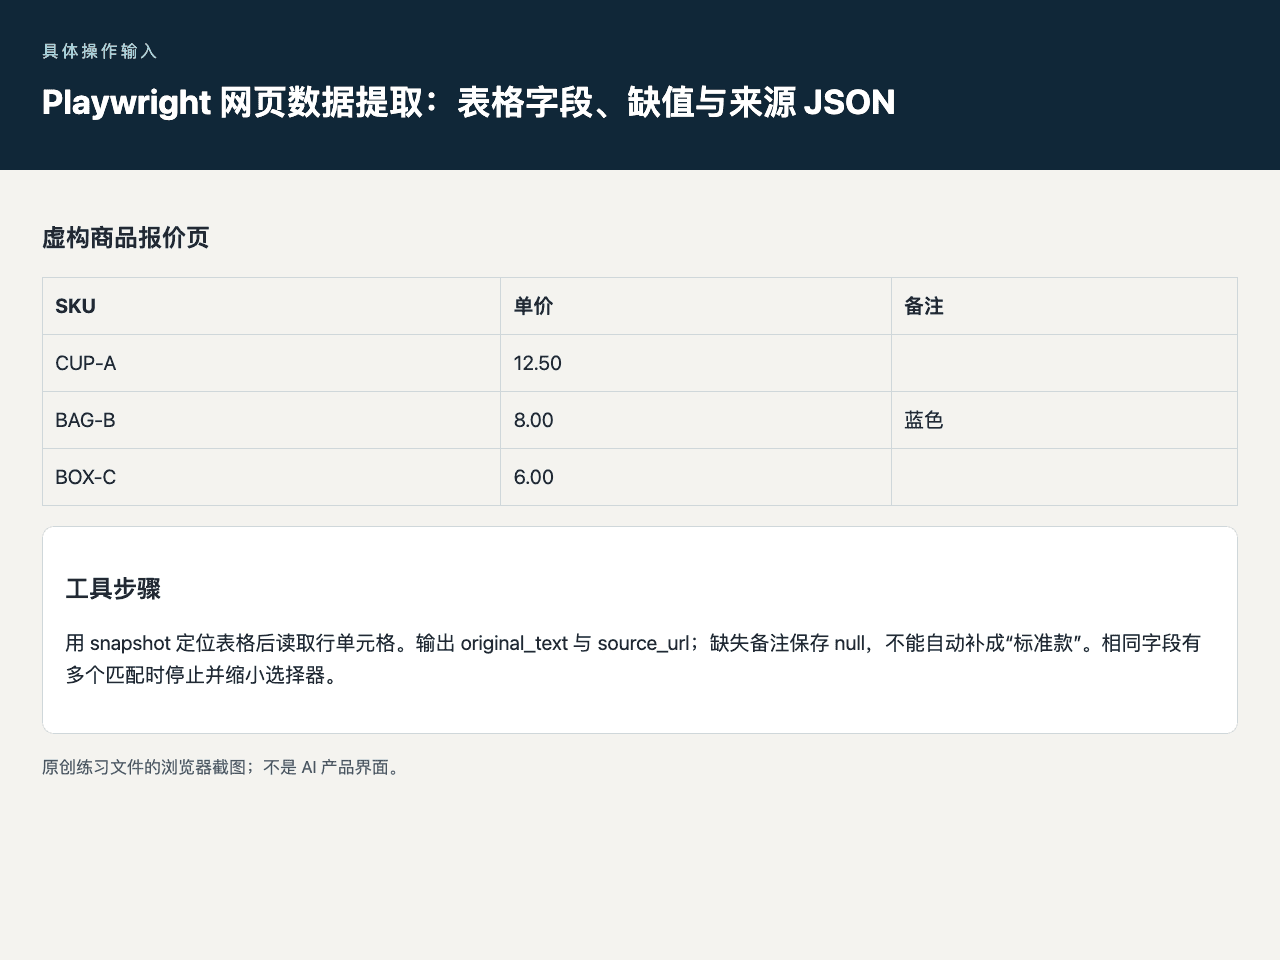
Playwright 网页数据提取,从自建报价页提取三个 SKU 的价格与备注,保留原始文本、页面 URL 和空字段,不补造缺失值。
阅读文章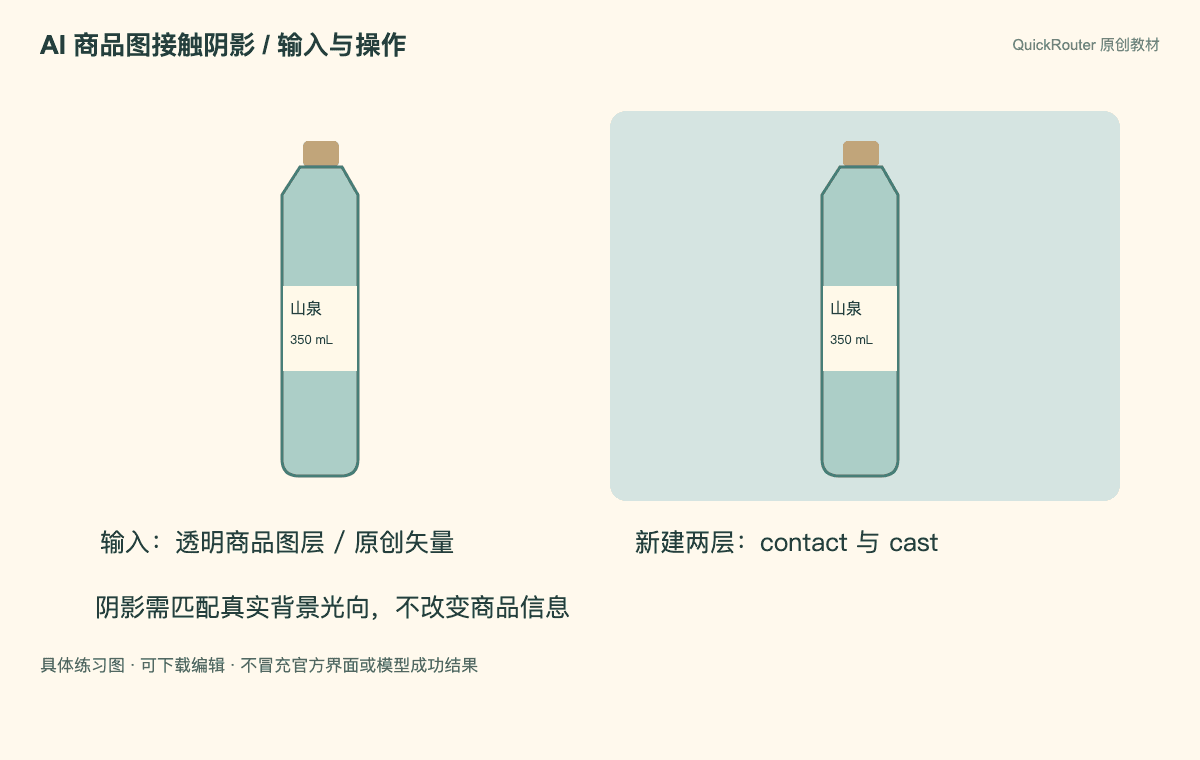
把 AI 背景与真实商品图层分开,在 Krita 画接触阴影与柔和投影,检查光向和商品底部。附原创瓶身输入及阴影图层练习。
阅读文章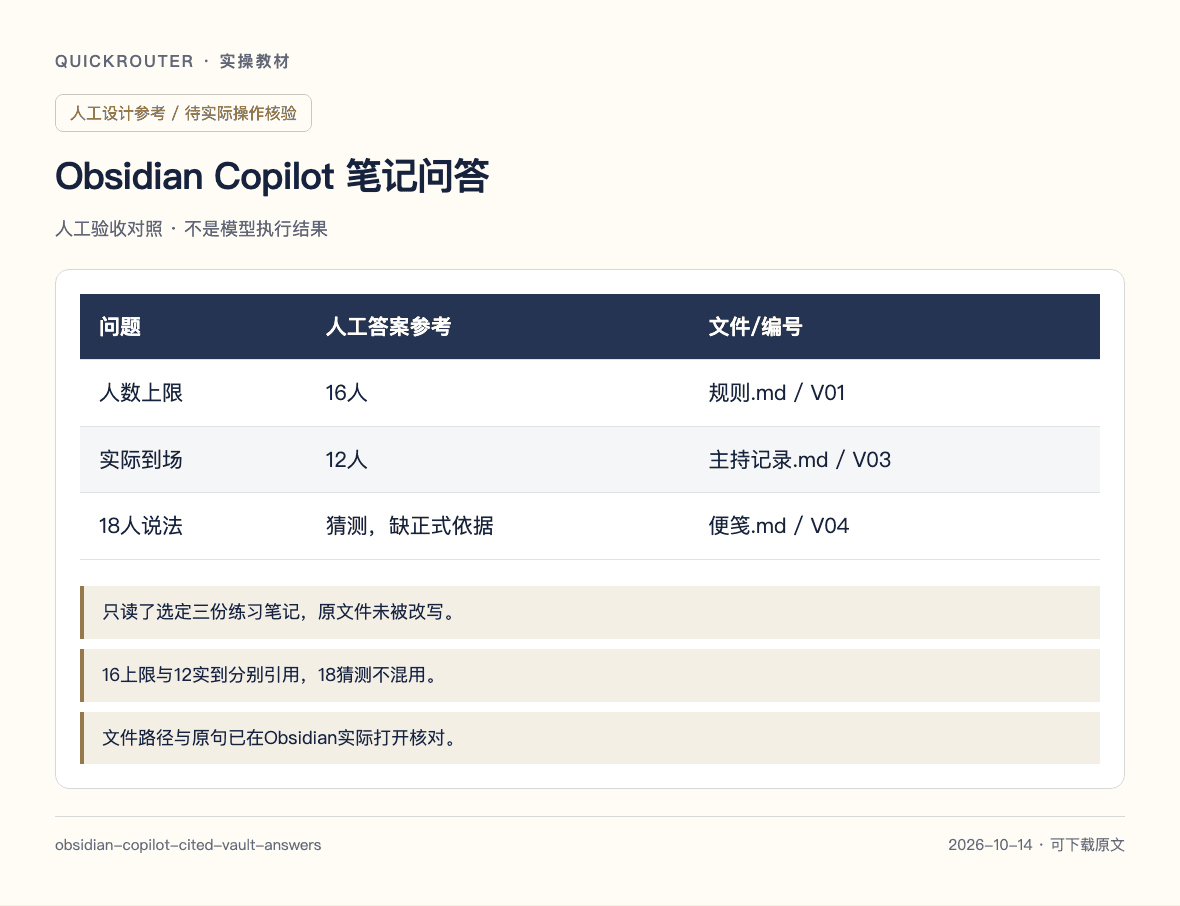
解压 vault-practice.zip,用 Obsidian 打开复制的练习vault。在社区插件中安装官方项目的 Copilot 并启用,按当前 Getting Started 配好一个你有权限的 Agent;本页不提供真实Key,也不代替模型账号。
阅读文章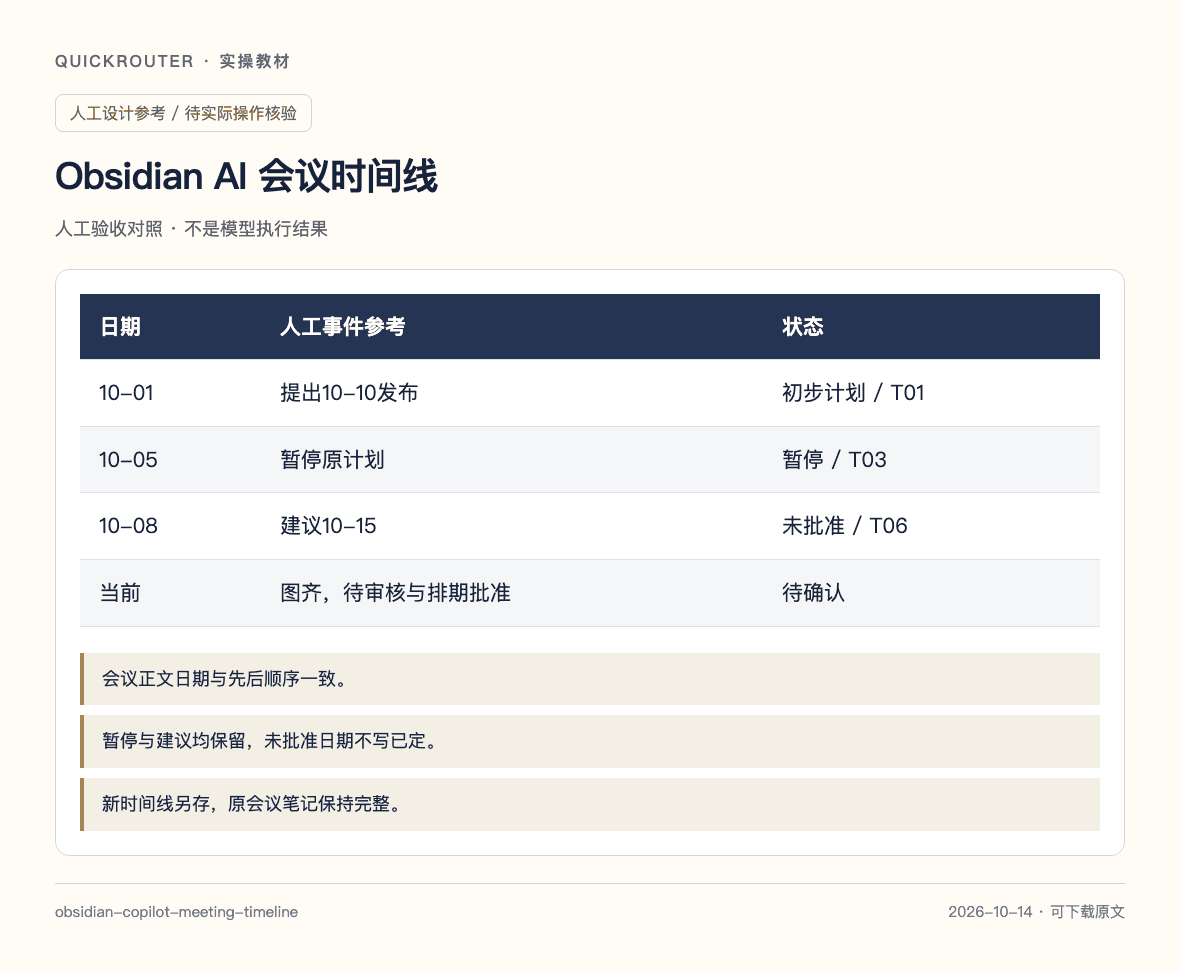
打开 meeting-vault.zip 的复制vault,启用已配置 Copilot。在 Agent Chat 附加三个会议笔记,或用 [[笔记标题]] 引用,使用普通读取任务;先列出三次会议的日期,确认不是文件修改时间。 时间线必须包含10月10日原计划和暂停事件,10月15日只作为建议。
阅读文章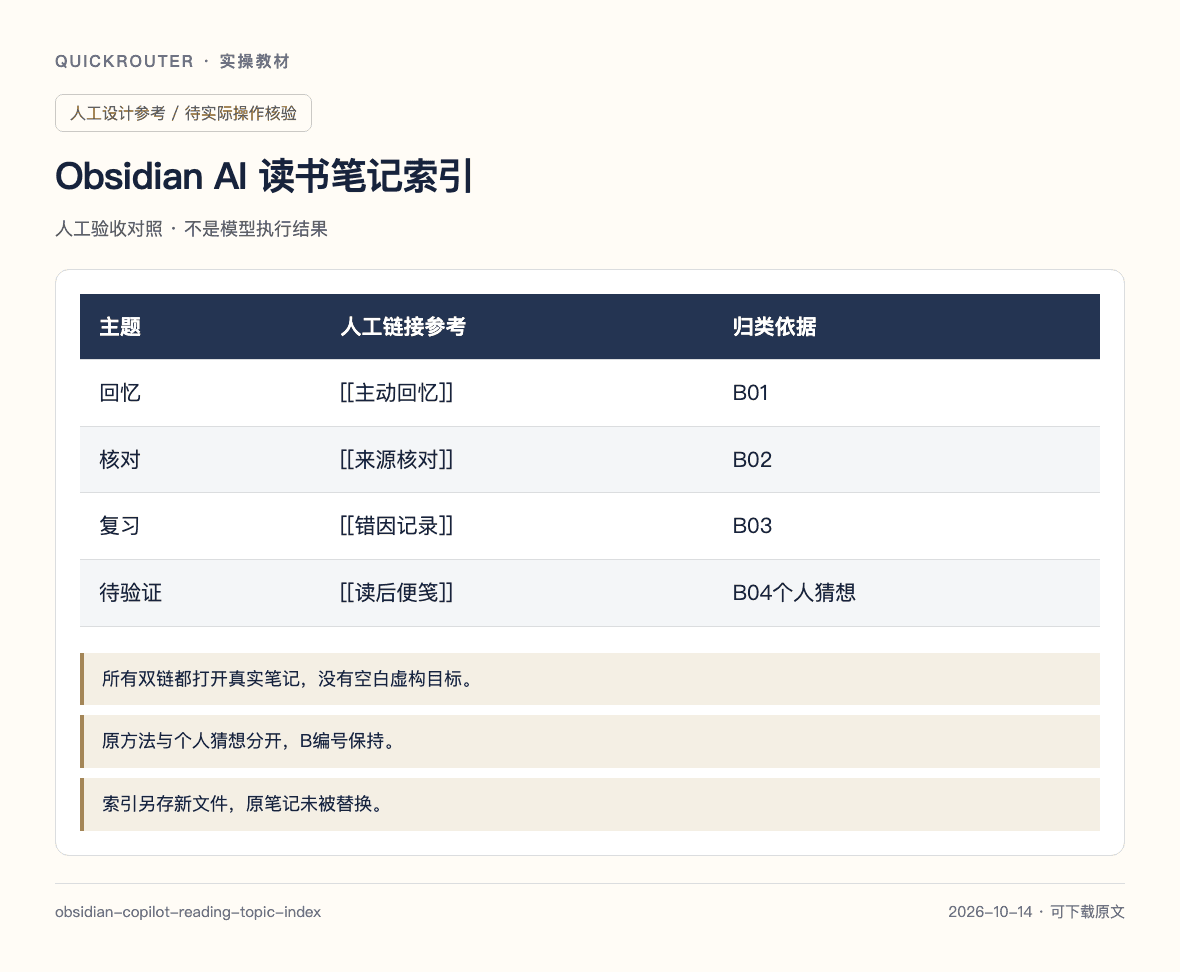
打开 reading-vault.zip 的复制vault,先手动看四个文件名。Copilot Agent 加入四份笔记上下文;若只做一段改写,可以在编辑器选择文本用 Quick Ask,当前需要配置 Quick Chat 模型。第一轮不替换原文。
阅读文章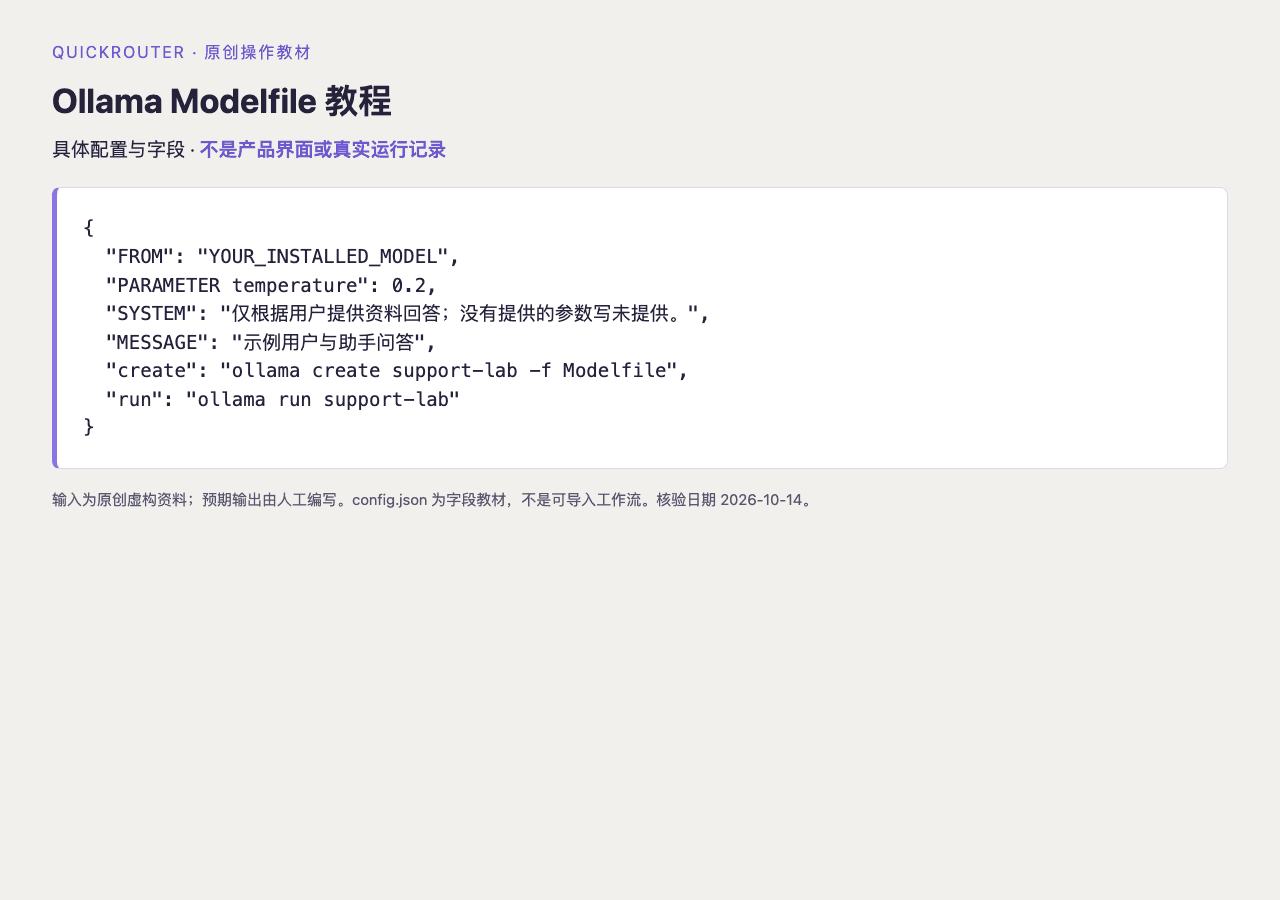
用FROM、SYSTEM、PARAMETER和MESSAGE创建本地助手。给出完整Modelfile、ollama create/run/show命令与两条问答,区分提示规则、自定义模型和训练。
阅读文章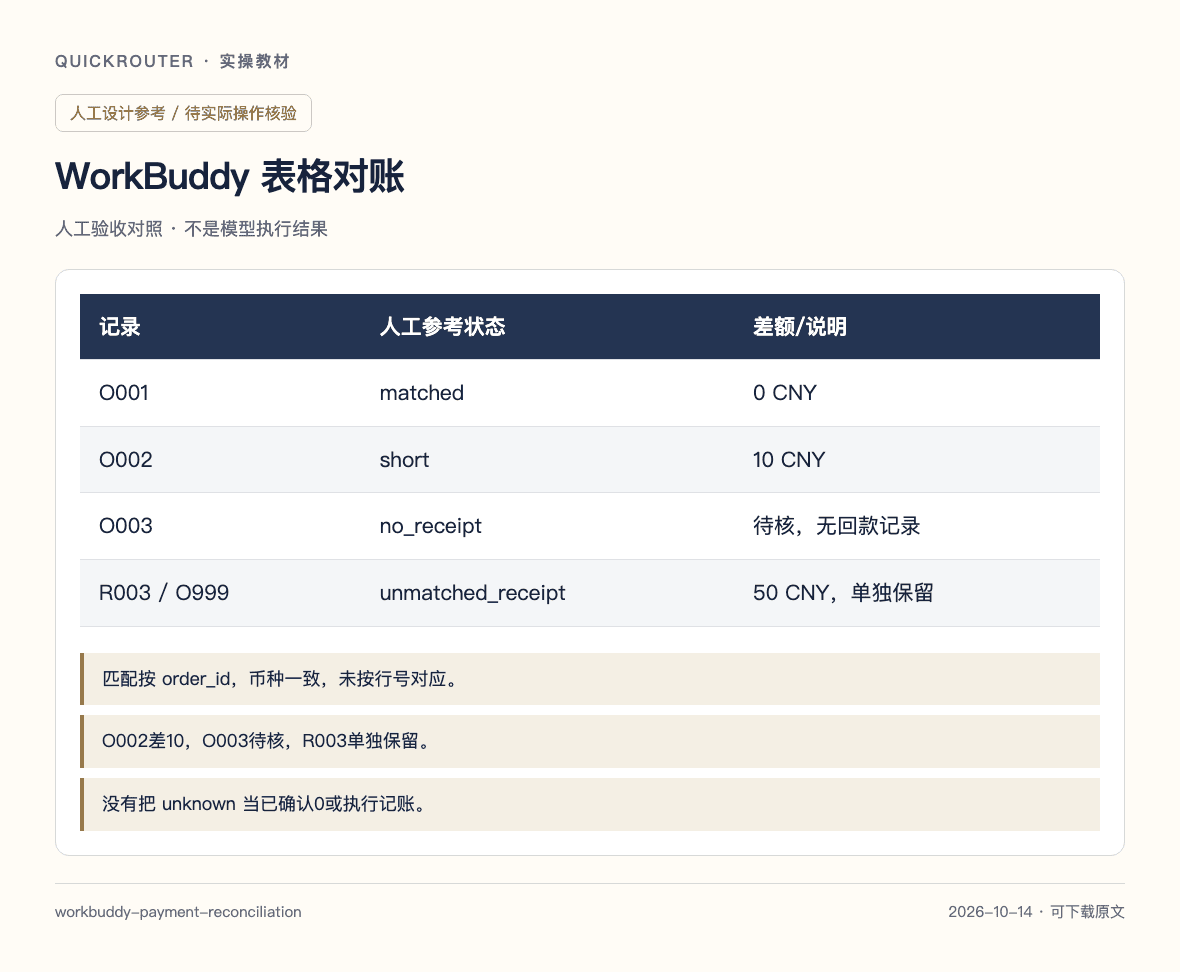
分别上传 orders.csv 和 receipts.csv,先让任务确认3个订单和3笔回款。指定两表文件名、匹配键与币种,再要求 reconcile.csv 和 unmatched.csv;不要把 receipts 第三行配到第三个订单。
阅读文章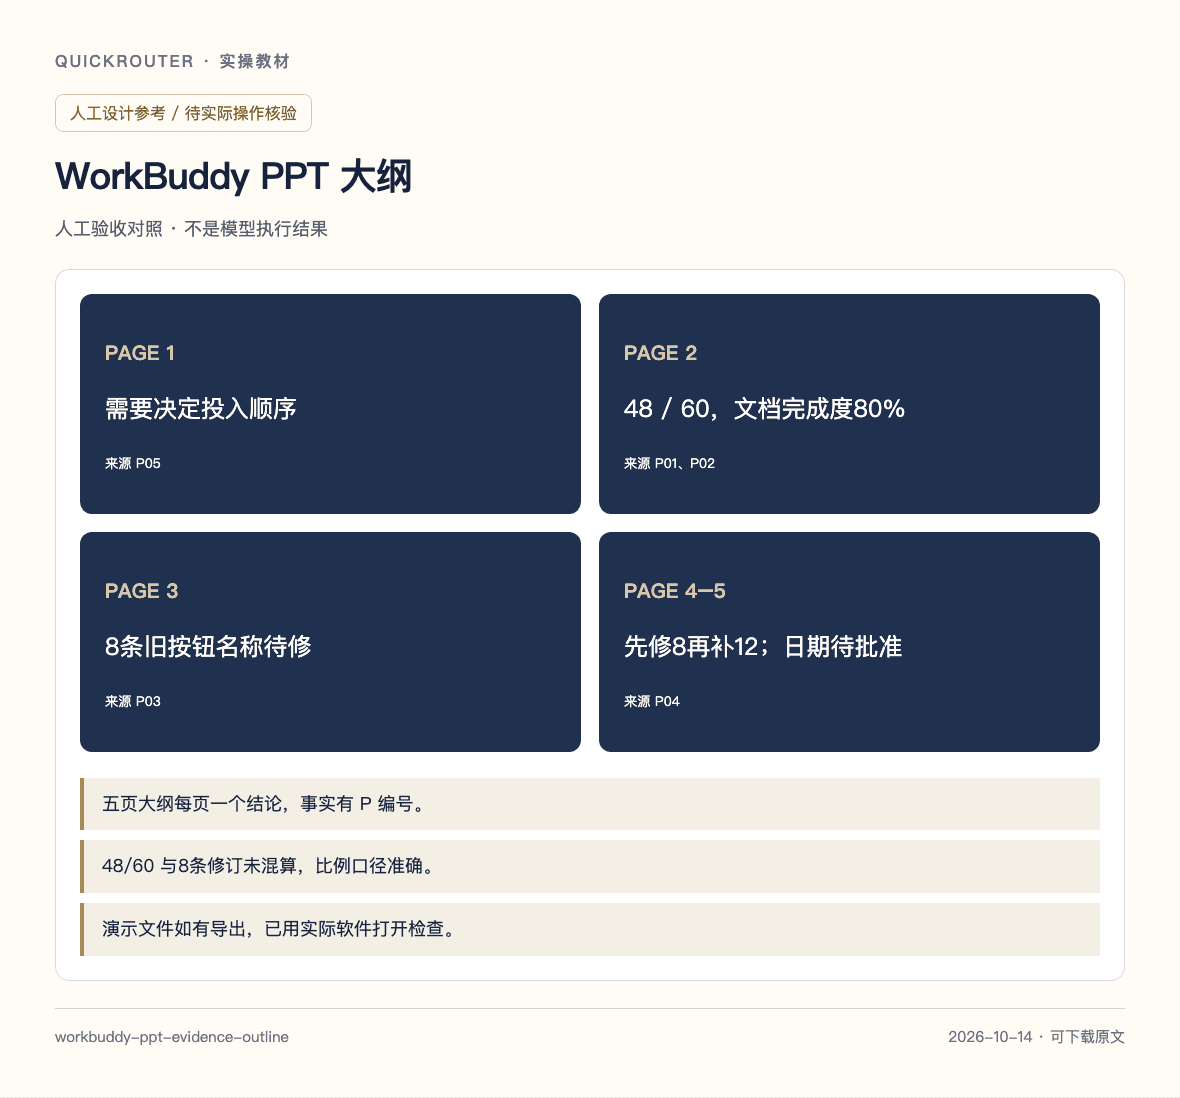
打开新任务,上传 project-brief.md。写明受众是产品团队、五页以内、每页只有一个结论。官方有素材制作 PPT 的路径,本练习先审大纲,审完再按你自己可用能力制作演示文件。 48÷60=80%,待补 12;旧名称 8 是修订事项。
阅读文章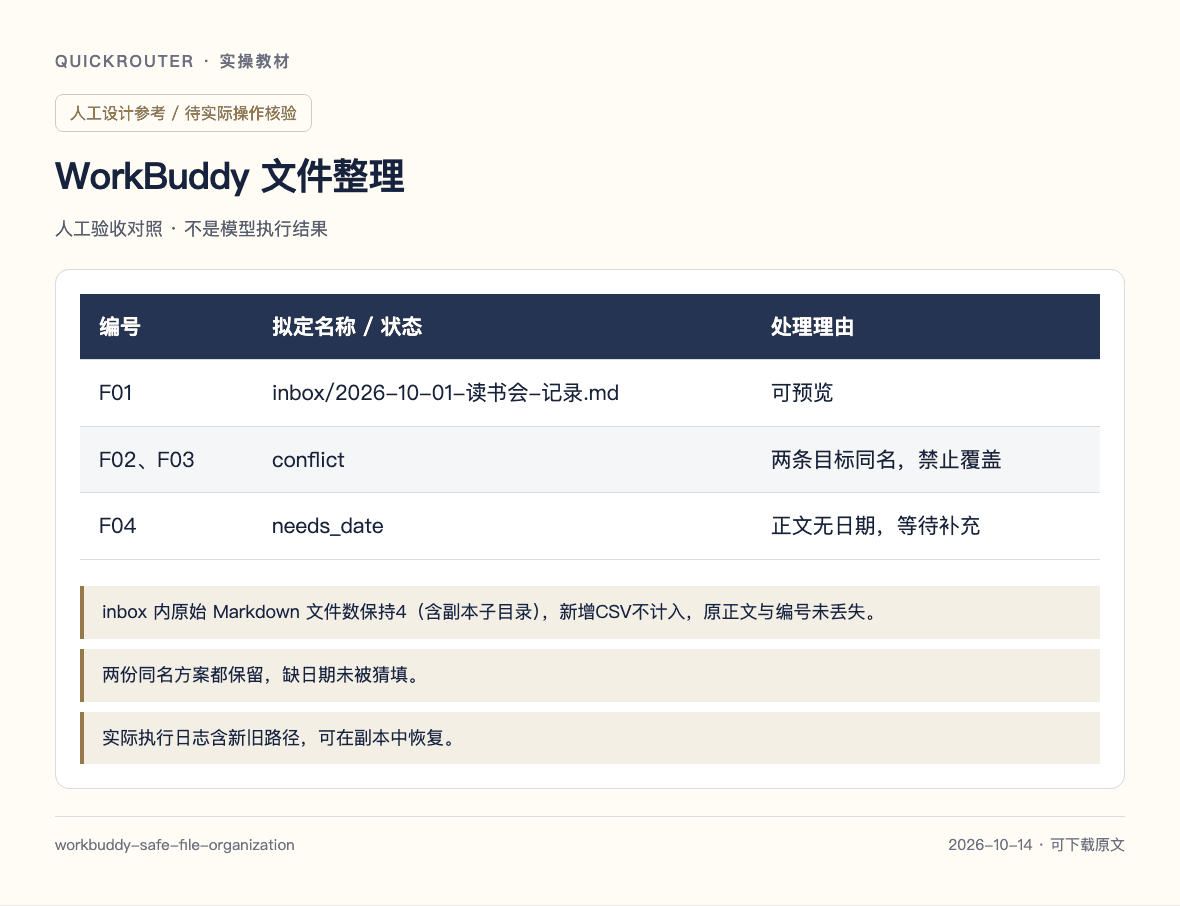
解压 file-practice.zip,复制一份命名 file-practice-working。创建任务时把这一份设为工作空间。先让 WorkBuddy 只读取 file-inventory.csv 和 4 个 Markdown 文件,不允许执行改名或删除。
阅读文章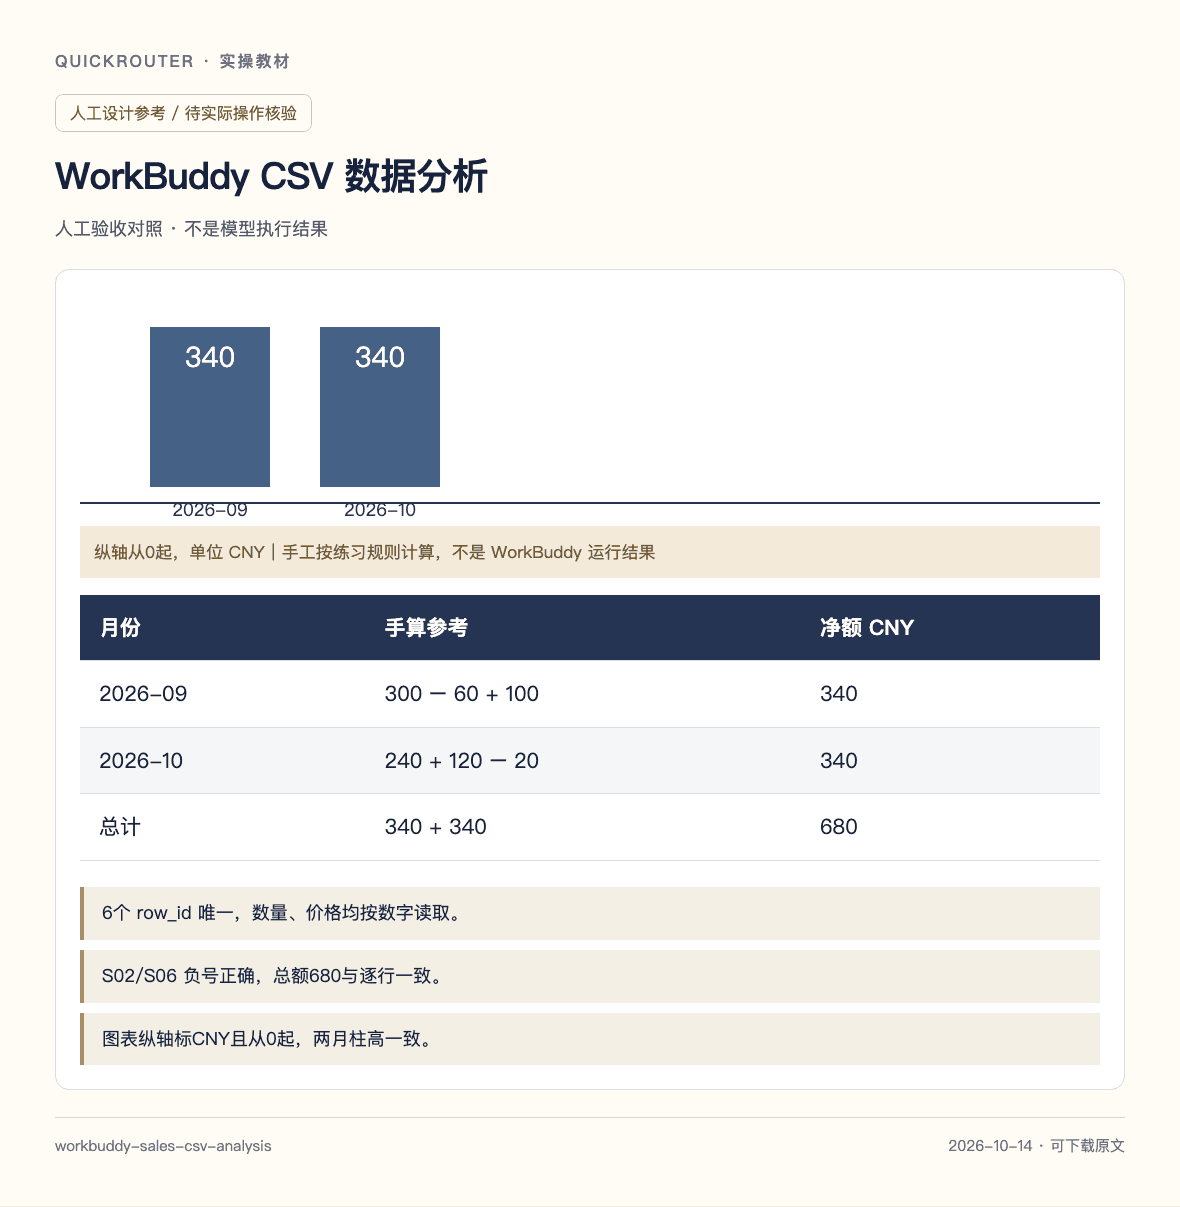
新任务拖入 sales.csv,先要求显示列名与6行数量。说明统计维度为 month,输出 summary.csv、计算说明和图表;图表来自已核对的汇总,不直接从猜测的叙述绘制。 9 月为 300-60+100=340,10 月为 240+120-20=340。总计 680。
阅读文章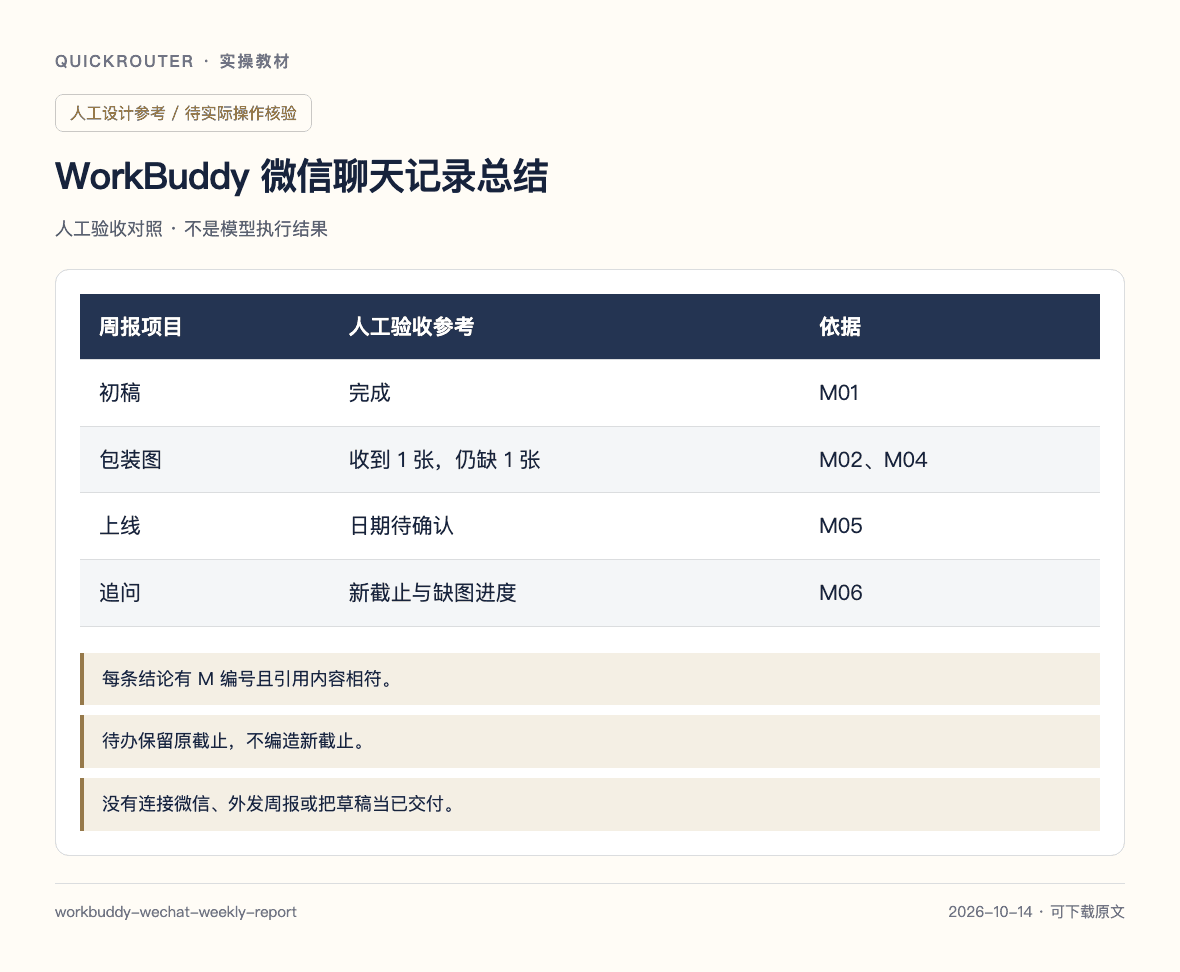
打开新任务,把下载的 wechat-notes.md 拖入输入框,或主动粘贴文字。官方更新记录描述了微信转发/系统分享能力;本练习采用文本文件,跨系统可复现。真实分享时先检查转发卡片内容是否完整。 按 M01 看初稿完成;按 M02/M04 看仍有一张包装图缺失;按 M05 看上线待定。
阅读文章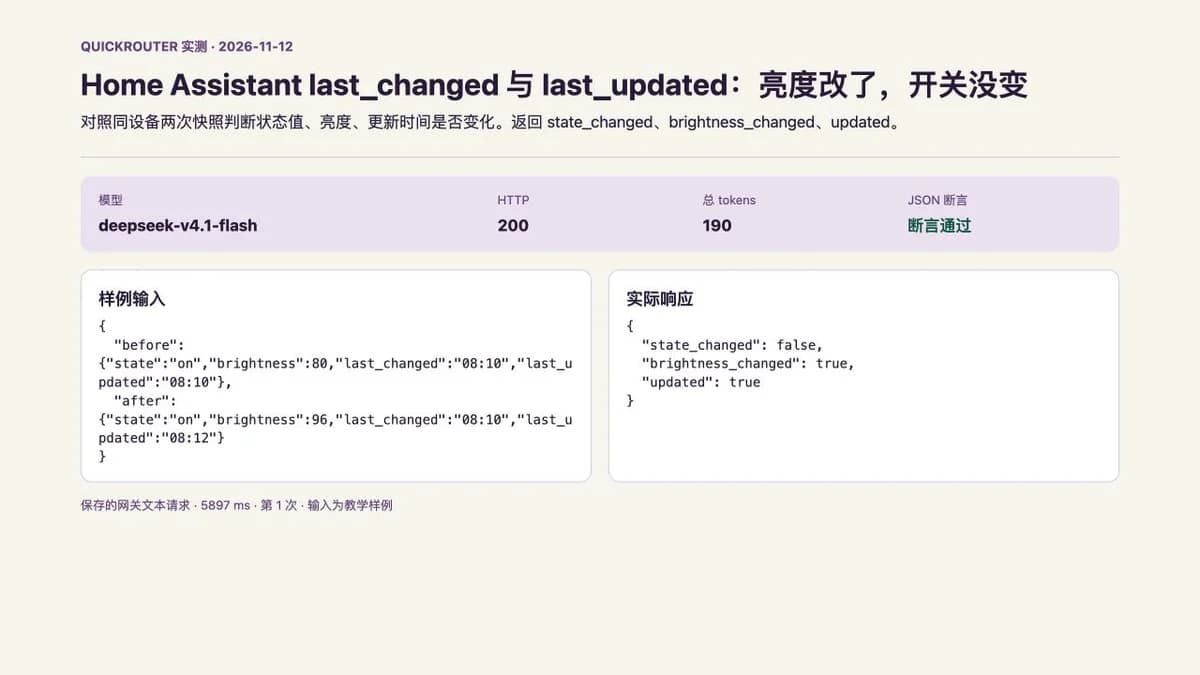
固定同一个 entity_id,对照两份快照中的 state、brightness、last_changed 和 last_updated。 实测附输入、响应、截图及复跑脚本。
阅读文章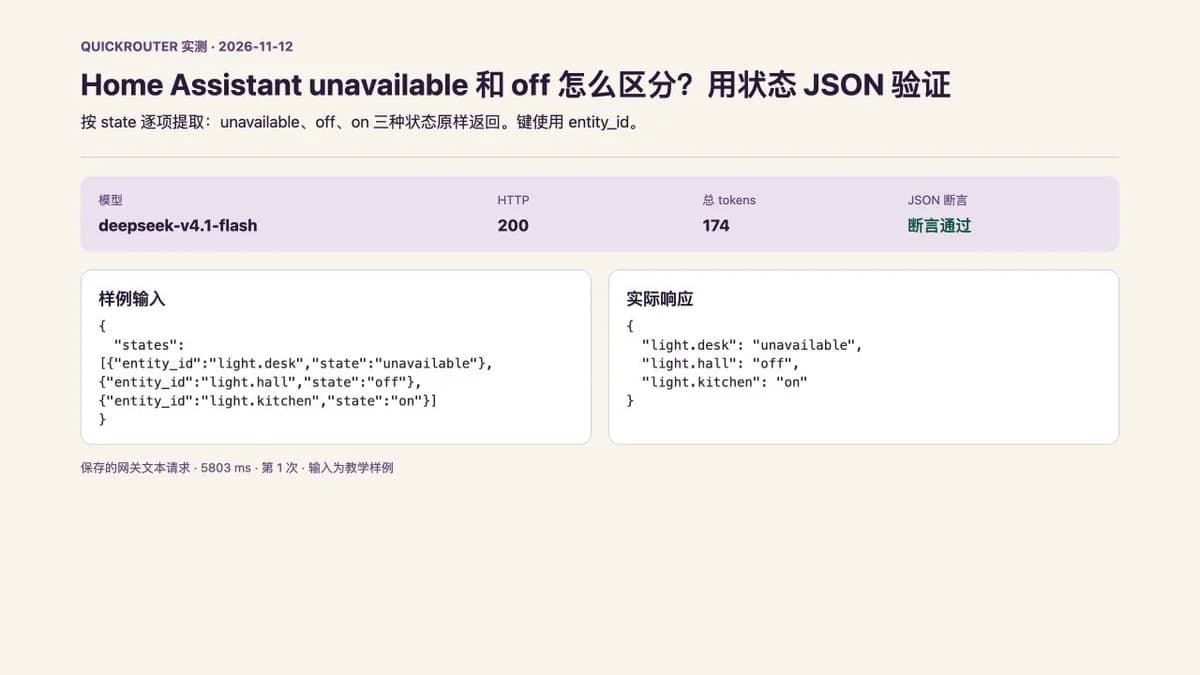
从 Home Assistant 状态导出复制 entity_id 和 state,用三种状态各取一个小样。 实测附输入、响应、截图及复跑脚本。
阅读文章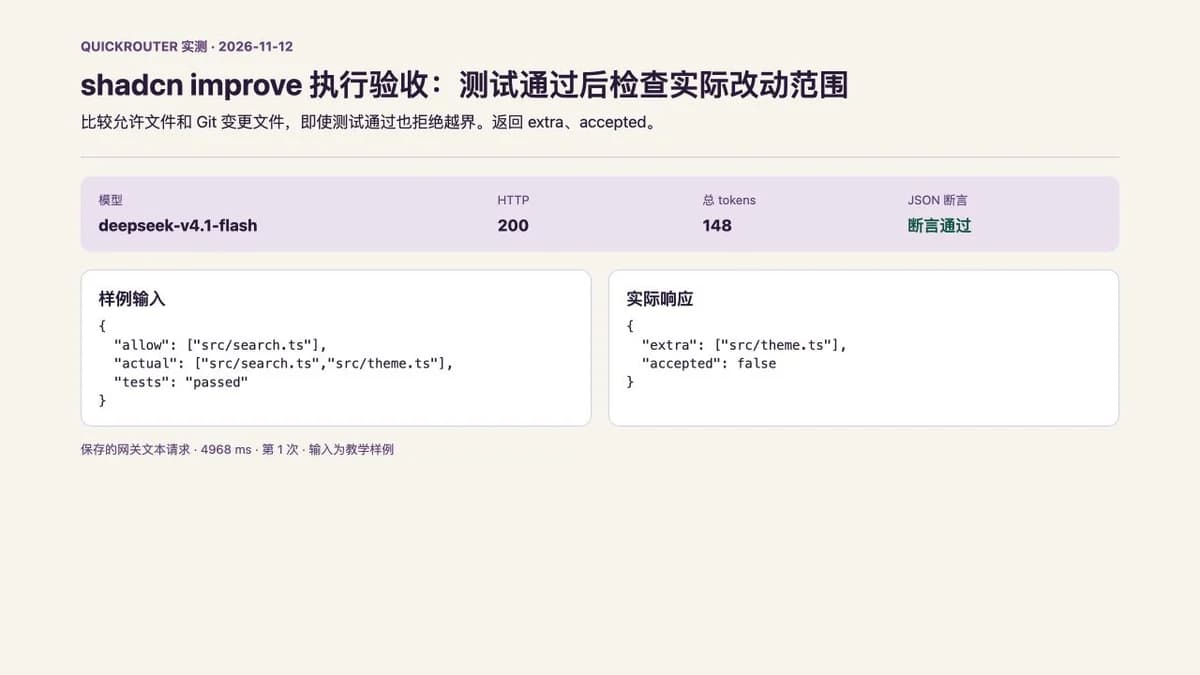
在计划里列出允许改动的文件,完成后检查 git diff --name-only,再运行验收测试。 实测附输入、响应、截图及复跑脚本。
阅读文章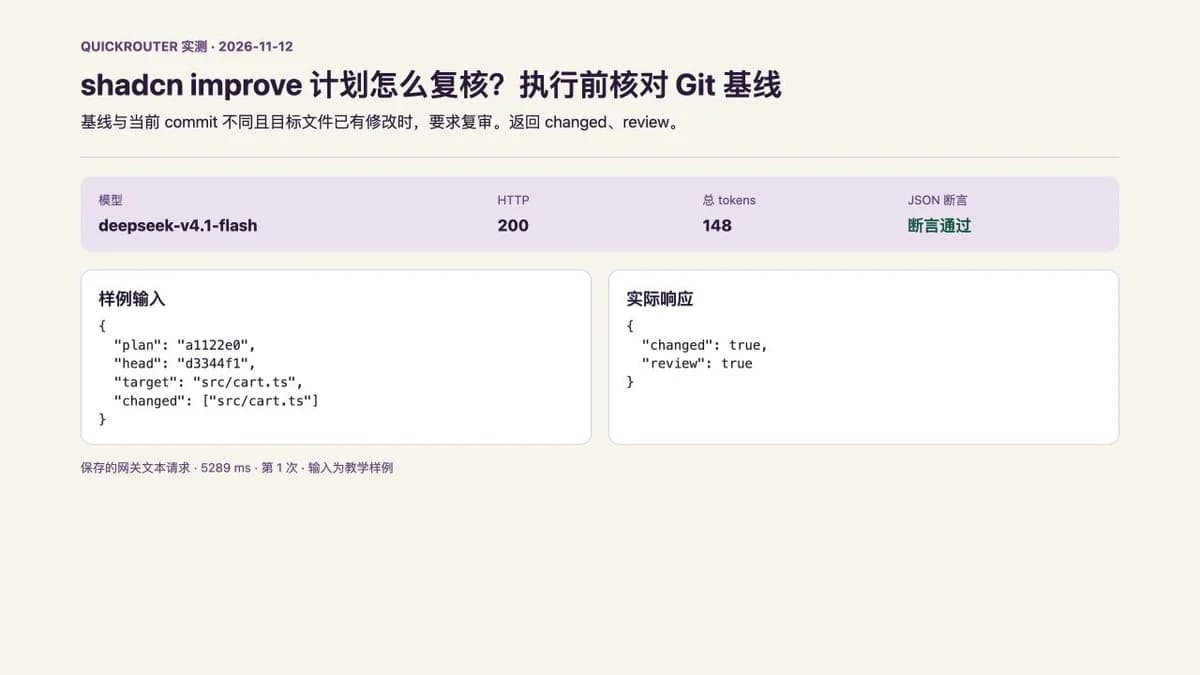
在计划头部写下 git rev-parse --short HEAD 的输出及要修改的目标文件。执行前再看 HEAD 和目标文件 diff。 实测附输入、响应、截图及复跑脚本。
阅读文章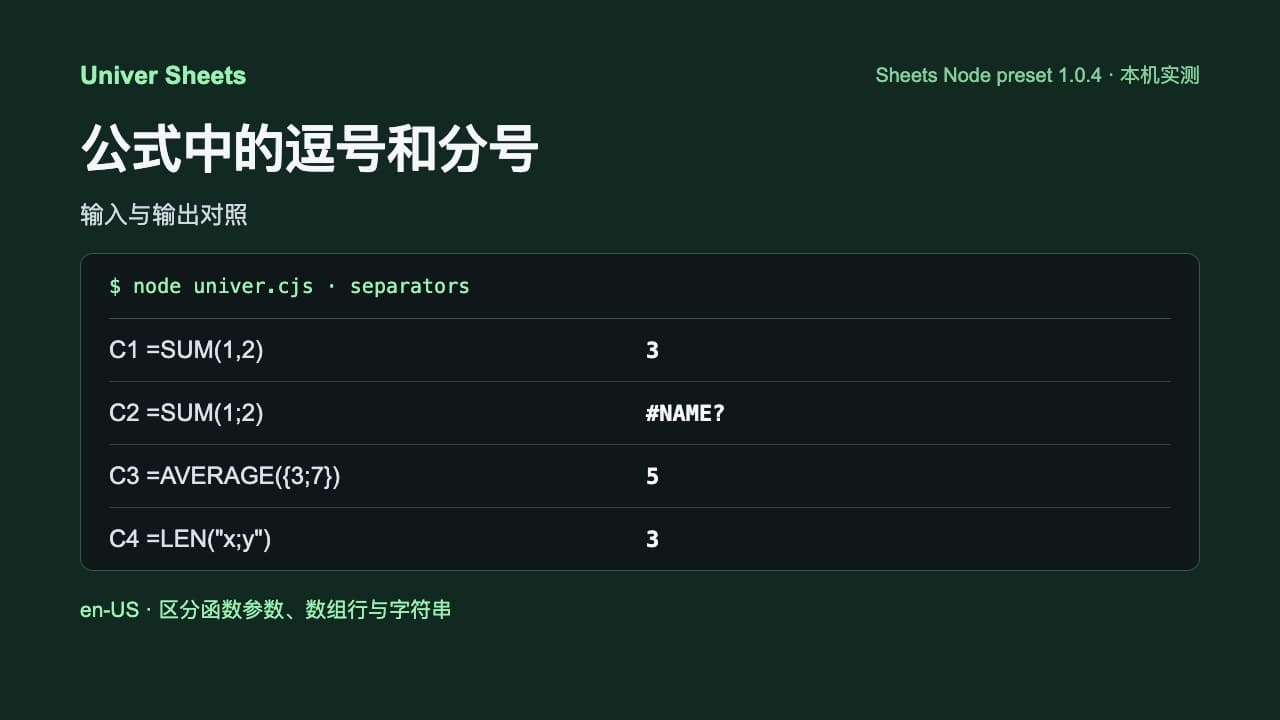
从本地化表格复制公式时,公式参数、数组行分隔符和字符串里的分号需要分别处理。先用最小样例确认目标运行环境的语法。
阅读文章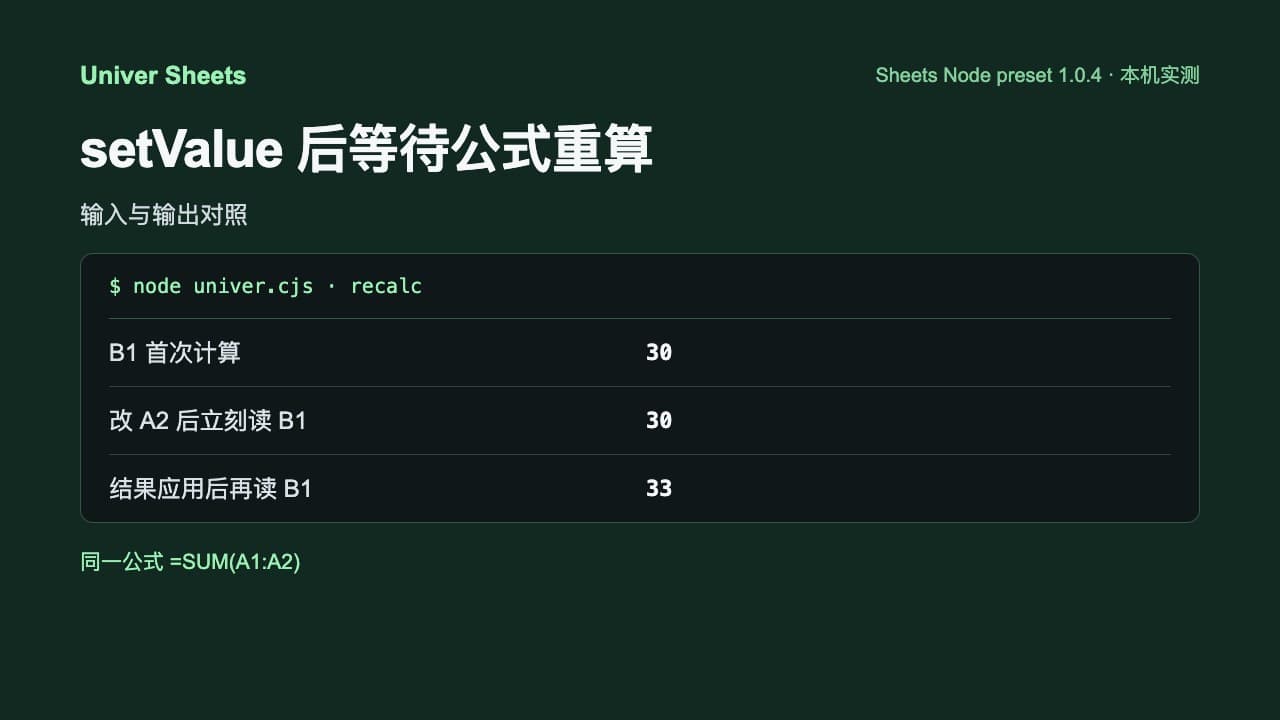
Univer 写入新的单元格值后,紧接着读取合计字段有时会拿到旧结果。用单元格对照确认计算完成的时机。
阅读文章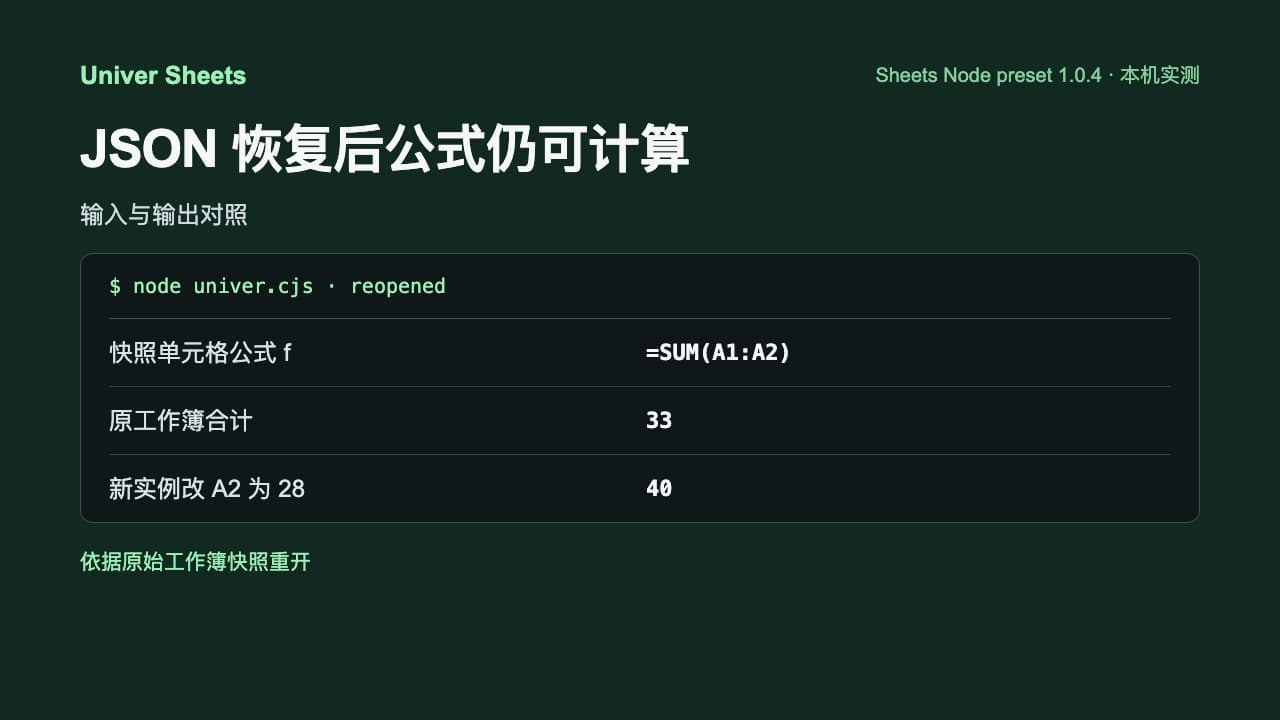
把电子表格保存成 JSON 时,除了能重新看到合计值,还要验证恢复后修改源单元格时公式仍能计算。
阅读文章
AI 扩图多尺寸先确定发布位置的真实宽高,再选择裁切、补边或生成新内容。把原图放进目标画布,明确补画方向;生成后检查接缝和主体,最后按交付尺寸确定性导出。
阅读文章
Chat Completions 迁移 Responses 要同时检查请求字段、输出读取和上下文策略。先迁移一个无工具文本流程,保留回滚路径,通过后再加入工具、流式事件与结构化输出。
阅读文章
中文摘要事实核对先把人物、日期、金额、否定和未知列成参考表。模型抽取结果要由原文证据支持;未写预算不是零,原计划不是实际上线,事实 JSON 通过也不代表文风优秀。
阅读文章
中文表格抽取测试先规定字段类型、金额精度与单位,再逐行检查。编号保留字符串,未知用 null;JSON 可解析只是起点,丢前导零、负号或单位仍然不通过。
阅读文章
JSON Schema 结构化输出先约束字段与类型,再用本地规则核对事实和业务关系。本页比较 JSON Mode 与 strict,处理 null、额外字段、拒绝和截断,不把结构合法当成内容真实。
阅读文章
长文引用怎么测试,使用带 ID 的固定片段,分别检查答案成立与引用支持。无答案应保留未知,未决矛盾并列说明;120 段是测试文档长度,不是模型上下文规格。
阅读文章
汇总本批六个真实 API 请求返回的 token 和断言结果,再用控制台实际费率计价。
阅读文章汇总本批六个真实 API 请求返回的 token 和断言结果,再用控制台实际费率计价。
阅读文章
读取本批六个请求的总耗时与 HTTP 状态,计算本样本中位数与范围。
阅读文章
在隔离配置下执行原生读取并对照 agents.defaults 和具体 Agent 的覆盖值。
阅读文章注册后创建 QuickRouter API Key,选择客户端和模型,再生成接入配置。从一次简单请求开始,按实际用量付费。
在控制台创建令牌,选择需要使用的模型权限。
按工具要求填写 API Key、接口地址与模型 ID。
确认收到有效结果,再到控制台查看用量与费用。