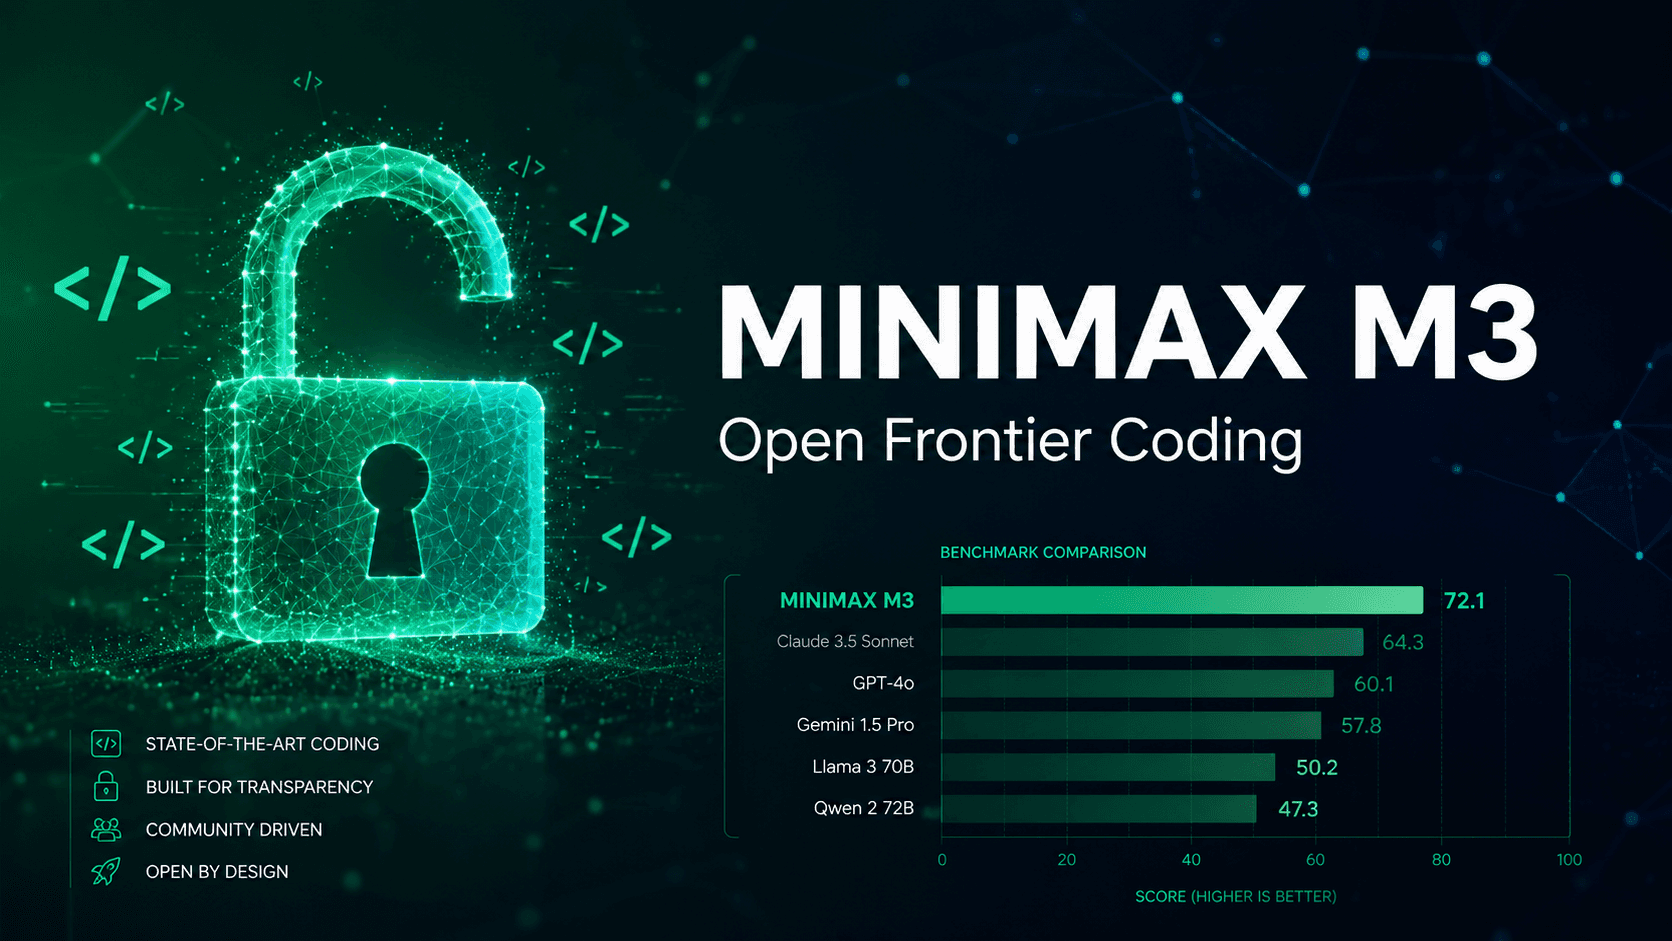
发布解读,非本站实测。 本文依据公开资料整理,未完成本文模型的付费接口测试。厂商基准只适用于其公布的版本、数据集与条件;未提供可复核来源、原始值及换算方法的衍生评分已撤下。 2026 年的大模型赛道,大多在卷一个维度:要么卷便宜、要么卷上下文、要么卷多模态。MiniMax 在 6 月 1 日发布的 M3 给出的赌注不太一样——它想同时把三件事做到 frontier 水平:前沿的编程能力、100 万 token 的上下文窗口、原生多模态。
这是官方自称的"第一个把 frontier coding + 1M 上下文 + 原生多模态揉进同一个开源模型"的尝试。更激进的,是它采用了全新的 MSA(MiniMax Sparse Attention)架构,并据公开评测称其在 SWE-Bench Pro 上的跑分超过了 GPT-5.5。
说明
本文的能力描述来自 MiniMax 官方发布与公开第三方评测,非本站实测。其中 SWE-Bench Pro 超越 GPT-5.5 的说法,部分媒体指出尚待独立复测验证,请留意甄别。
一、MiniMax M3 在卷什么?官方公布的三件事
1. MSA:MiniMax Sparse Attention 新架构
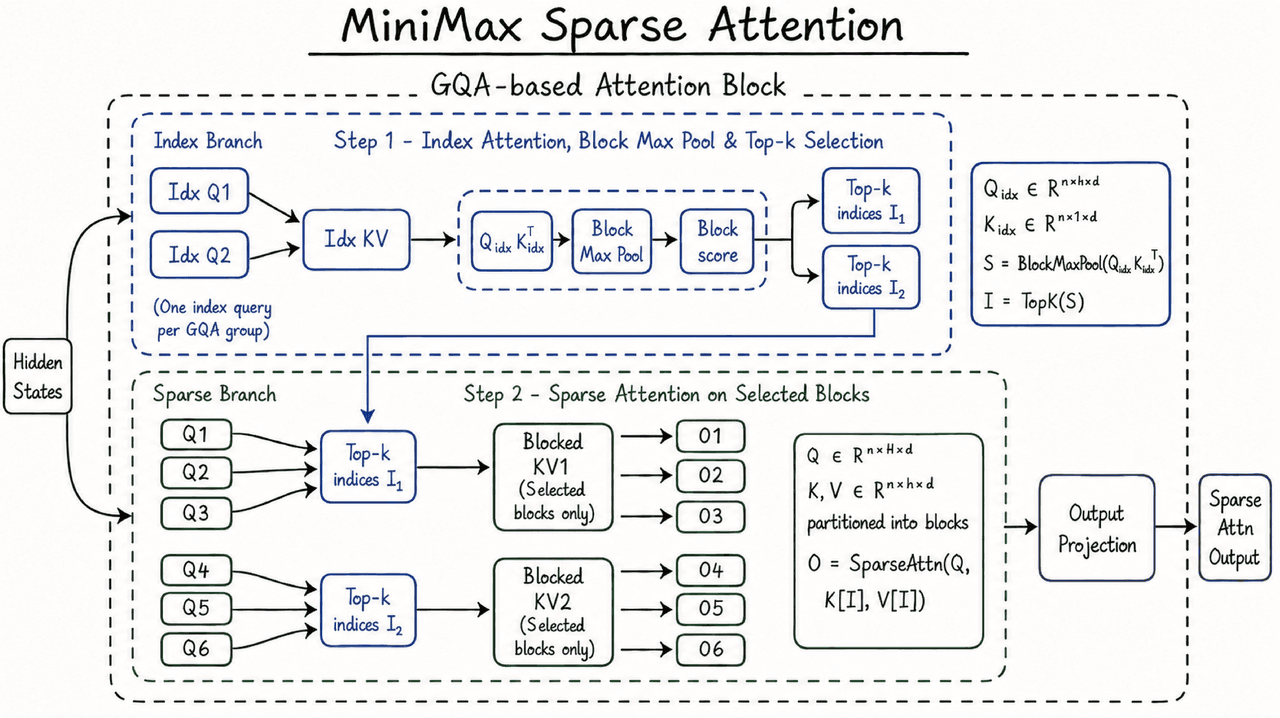
M3 最核心的工程亮点是全新的 MSA(MiniMax Sparse Attention)架构。传统 Transformer 注意力机制是"全连接"的,上下文越长计算量呈平方级膨胀。MSA 的思路是稀疏化:只让每个 token 关注真正需要关联的部分,从而在超长上下文下把计算开销压下来。
正是这套架构让 M3 能在不爆炸的算力预算下跑通 100 万 token 上下文。
2. 第一个"三位一体"的开源模型
| 能力维度 | M3 的定位 |
|---|---|
| Frontier 编程 | 接近闭源旗舰的 agentic coding 能力 |
| 1M 上下文 | 100 万 token 原生窗口(MSA 支撑) |
| 原生多模态 | 图文输入,非外挂拼接 |
3. Agentic coding + computer-use
M3 不仅会写代码,还具备操作计算机界面(computer-use)的潜力——看截图、定位元素、执行点击/输入。
来源:MiniMax 官方博客
二、实测案例:公开评测数据
案例 1:SWE-Bench Pro
| 基准 | M3(公开评测) | 对比 | 备注 |
|---|---|---|---|
| SWE-Bench Pro | 据称超越 GPT-5.5 | 领先闭源旗舰 | 部分媒体指出尚待独立复测 |
来源:公开第三方评测,2026-06
案例 2:长上下文
| 任务类型 | 1M 上下文的典型价值 |
|---|---|
| 整仓库代码理解 | 单次读入完整项目,跨文件追踪依赖 |
| 超长文档总结 | 减少切分检索,降低信息丢失 |
| 多轮 Agent 上下文累积 | 长程 agent 任务不掉链子 |
案例 3:多模态 + computer-use
| 能力组合 | 典型场景 |
|---|---|
| 多模态 + agentic coding | 看设计稿/截图 → 输出对应代码 |
| 多模态 + computer-use | 自动化界面操作、截图诊断 |
关于跑分的补充
computer-use 类能力在生产环境中的可靠性通常远低于跑分所示,建议优先用真实任务验证。
三、价格
MiniMax M3 / M2.7 / GLM-5.2 价格对比
美元基准价 · token 价按每百万标注;其他计费方式见价格页
| 模型 | 厂商 | 类型 | 输入 | 输出 |
|---|---|---|---|---|
| MiniMax-M3 | — | — | —/百万token | —/百万token |
| MiniMax-M2.7 | — | — | —/百万token | —/百万token |
| glm-5.2 | — | — | —/百万token | —/百万token |
怎么选更省钱
M3 和 M2.7 定价档位相同。如果不需要 1M 上下文或多模态,前代 M2.7 更划算。
四、国内怎么调用?
4 步跑通 · MiniMax M3
兼容 OpenAI SDK 与常用工具,高速直连
注册账号
Google 或 GitHub 账号直接登录
复制 API Key
控制台创建令牌即可使用
配置 Base URL
兼容 OpenAI SDK 与常用工具
验证首次调用
核对实际回答与控制台日志
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ["QUICKROUTER_API_KEY"],
  base_url="https://api.quickrouter.ai/v1"
)

response = client.chat.completions.create(
  model="MiniMax-M3",
  messages=[{"role": "user", "content": "你好"}]
)

print(response.choices[0].message.content)该示例未执行此模型调用。请核对真实回答、状态码和控制台记录。
核对这个型号的请求与结果

本站绘制的内容说明图:这是本篇展示的短文本连通性示例;未执行该型号调用,不能代替完整任务、工具功能或效果测试。
五、该不该用它?
| 你的场景 | 推荐 | 理由 |
|---|---|---|
| 长程编程 + 整仓库理解 | MiniMax M3 | 1M 上下文 + MSA |
| 多模态驱动编程 | MiniMax M3 | 原生多模态 + agentic coding |
| 纯编程、不需超长上下文 | M2.7 或 GLM-5.2 | 价格同档,能力够用 |
| 需要最高可靠性/零幻觉 | 闭源旗舰 | 开源模型在对齐度上仍有差距 |
信息来源:本文能力描述来自 MiniMax 官方发布及公开第三方评测,非本站实测。其中 SWE-Bench Pro 超越 GPT-5.5 的结论,部分媒体指出尚待独立复测验证。价格数据为发布当日(2026-06-03)QuickRouter 控制台快照,最新价格请以控制台价格页为准。
操作与使用问题
MiniMax M3 支持 Computer Use 就能靠普通 API 操作电脑吗?
先确认客户端提供的工具、权限与结果回传,验证一个明确动作。模型建议或公开能力说明不能代替真实电脑操作记录。
MiniMax M3 长上下文任务怎样核对成本?
记录实际输入长度、输出、工具回合及重试,再对照目标通道的计价档位。原文基础价格不能覆盖所有长输入条件。
查看相关型号
在型号详情中核对最低价格、参数、接口示例与使用限制,再选择配置方式。
把选好的模型,接入你的应用
从 Claude、GPT、Gemini 等模型中选择所需能力。获取 API Key,按工具配置接口地址,再用一个小请求确认结果和费用。
创建 API Key
在控制台创建令牌,选择需要使用的模型权限。
填写接入配置
按工具要求填写 API Key、接口地址与模型 ID。
发起第一次调用
确认收到有效结果,再到控制台查看用量与费用。
继续阅读

GPT Image 2.6 评测:6 秒出图、原生 GIF,Flare 和 Sunburst 怎么选
基于 OpenAI 官方发布与公开评测,解读 GPT Images 2.6——延续 Flare/Sunburst 双变体:生成提速 50%(Flare 低画质档最快 6 秒)、原生动图 GIF(16 帧与静态图同价)、Markup 标注编辑、SVG 矢量导出,价格不变。AA 双榜登顶。公开实测 8 组对比:SOTA 仍会在透视翻车,日常首选 Flare。附 QuickRouter 实时价格与国内直连接入代码。

GPT-6.1 Terra 评测:排名比 Kimi 高,但更高的排名不等于更全能
基于 OpenAI 官方发布与公开评测,解读 GPT-6.1 Terra——GPT-6.1 家族的中档主力:$1/$5 定价、Agents' Last Exam 60.0% 反超 Kimi K3.1 Pro、MMMU-Pro 85.5% 同级首个破 85、幻觉率暴降、三倍执行速度、家族唯一支持零思考秒回。公开实测:多模态推理胜 Kimi,但 3D 与复杂创意全面落败——高频自动化之选,非全能选手。附 QuickRouter 实时价格与国内直连接入代码。

Kimi K3.1 Pro 评测:99 天 RL 重炼,Terminal-Bench 65.7% 咬住 Opus 5.5
基于 Moonshot 官方发布与公开评测,解读 Kimi K3.1 Pro——K3 的 2.8T 骨架 + 99 天 RL 后训练:Terminal-Bench 4.0 65.7%、SWE-Marathon 51.7%、DeepSWE 75.5% 多项第一,幻觉率 23.4% 砍到 8.3%,API 降价三分之一至 $2/$10 并开源权重。公开实测:3D 与前端视觉惊艳、力压 GPT-6 Astra。附 QuickRouter 实时价格与国内直连接入代码。