发布解读,非本站实测。 本文依据公开资料整理,未完成本文模型的付费接口测试。厂商基准只适用于其公布的版本、数据集与条件;未提供可复核来源、原始值及换算方法的衍生评分已撤下。 xAI 交出的答卷是 Grok 4.2。它把火力集中在两件事上:软件工程能力(SWE-Bench) 和 速度 / 成本优化。同系列旗舰 Grok 4 Heavy 是首个在 Humanity's Last Exam(HLE)上突破 50% 的模型。
说明
本文的能力描述来自 xAI 官方发布与公开第三方评测,非本站实测。
一、Grok 4.2 在卷什么?官方公布的三件事
根据 xAI 官方发布,升级重点可以归纳成三件事。
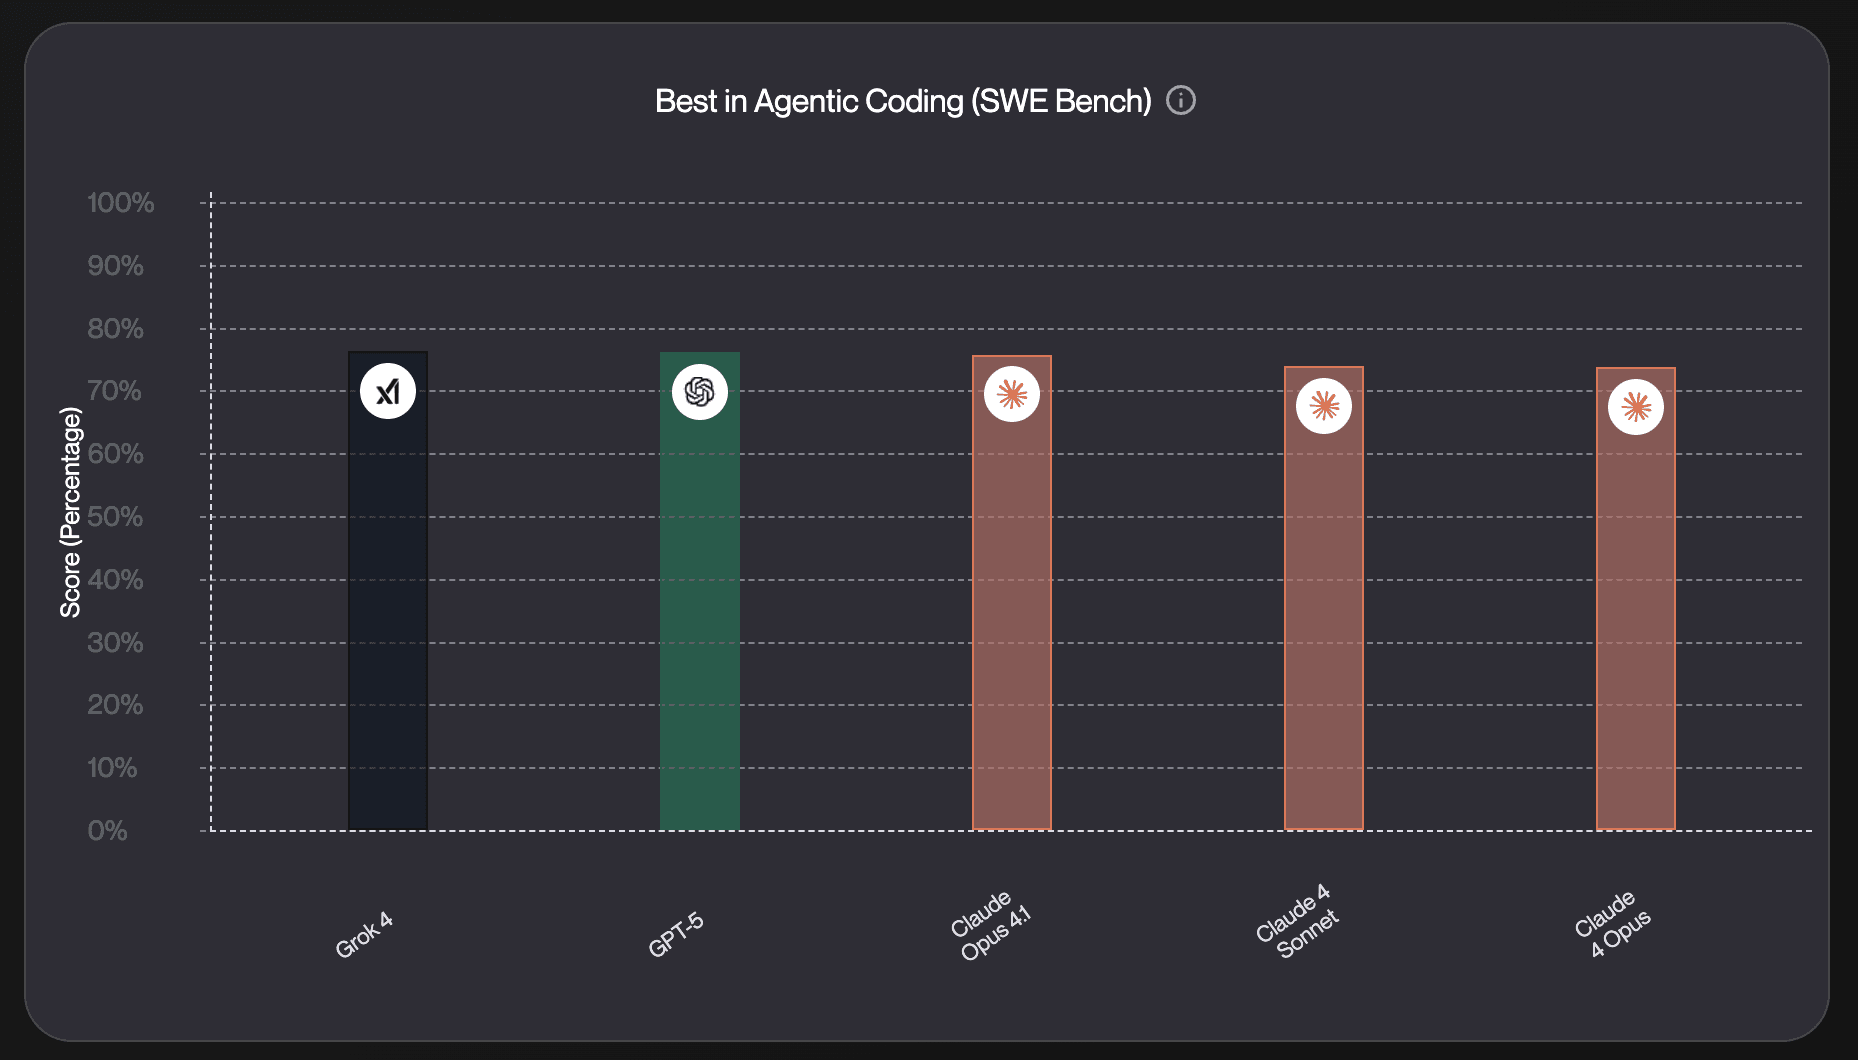
1. 软件工程能力:SWE-Bench 内部 70.8%
在 SWE-Bench 的内部评测上达到 70.8%,意味着它在"读懂代码库、定位问题、提交可用修复"这件事上已经进入第一梯队。
2. 为速度与成本优化
在不牺牲工程能力的前提下,把单次调用的延迟和成本压下来。
3. 同系列旗舰首破 HLE 50%
Grok 4 Heavy 是首个在 Humanity's Last Exam(HLE)上拿到 50% 的模型。
二、Grok 4.2 比 Grok 4 强在哪?
案例 1:软件工程与推理
| 对比维度 | Grok 4.2 | Grok 4 | Claude Sonnet 4.6 |
|---|---|---|---|
| SWE-Bench | 70.8%(内部) | 较高 | 高 |
| HLE(系列旗舰) | 50%(首破) | 50% | 较高 |
来源:xAI 官方发布,2026-05
案例 2:速度与成本
| 对比维度 | Grok 4.2 | Grok 4 |
|---|---|---|
| 速度定位 | 主打快 | 基准 |
| 成本定位 | 主打低 | 基准 |
| 工程能力保持 | 是 | — |
三、它值多少钱?实时价格
Grok 4.2 / Grok 4 / Sonnet 4.6 价格对比
美元基准价 · token 价按每百万标注;其他计费方式见价格页
| 模型 | 厂商 | 类型 | 输入 | 输出 |
|---|---|---|---|---|
| grok-4.2 | — | — | —/百万token | —/百万token |
| grok-4 | — | — | —/百万token | —/百万token |
| claude-sonnet-4-6 | — | — | —/百万token | —/百万token |
四、国内怎么调用?
4 步跑通 · Grok 4.2
兼容 OpenAI SDK 与常用工具,高速直连
注册账号
Google 或 GitHub 账号直接登录
复制 API Key
控制台创建令牌即可使用
配置 Base URL
兼容 OpenAI SDK 与常用工具
验证首次调用
核对实际回答与控制台日志
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.environ["QUICKROUTER_API_KEY"],
  base_url="https://api.quickrouter.ai/v1"
)

response = client.chat.completions.create(
  model="grok-4.2",
  messages=[{"role": "user", "content": "你好"}]
)

print(response.choices[0].message.content)该示例未执行此模型调用。请核对真实回答、状态码和控制台记录。
核对这个型号的请求与结果


五、该不该用它?
| 你的场景 | 推荐 | 理由 |
|---|---|---|
| 真实软件工程 / 仓库级 bug 修复 | Grok 4.2 | SWE-Bench 70.8%(内部) |
| 高频调用 / 批量代码任务 | Grok 4.2 | 主打速度与成本 |
| 自动化代码审查 / 流水线 | Grok 4.2 | 又快又便宜 |
| 需要极致推理 / 零幻觉 | 看需求 | 不同旗舰各有侧重 |
信息来源:本文能力描述来自 xAI 官方发布及公开评测,非本站实测。价格数据为发布当日(2026-05-03)QuickRouter 控制台快照,最新价格请以控制台价格页为准。
操作与使用问题
Grok 4.2 的 SWE-Bench 数据能代表仓库修复一定成功吗?
核对公开题集、环境与来源,再固定自己的仓库和失败用例验收。基准与具体业务错误不同,检查 diff 和真实测试输出才知道任务完成情况。
Grok 4.2 与同系列 Heavy 的指标能混在一起吗?
分开记录型号、评测条件和价格,不能将系列旗舰结果自动归给普通型号。实际调用按当前目录准确 ID 核对。
把选好的模型,接入你的应用
从 Claude、GPT、Gemini 等模型中选择所需能力。获取 API Key,按工具配置接口地址,再用一个小请求确认结果和费用。
创建 API Key
在控制台创建令牌,选择需要使用的模型权限。
填写接入配置
按工具要求填写 API Key、接口地址与模型 ID。
发起第一次调用
确认收到有效结果,再到控制台查看用量与费用。
继续阅读

GPT Image 2.6 评测:6 秒出图、原生 GIF,Flare 和 Sunburst 怎么选
基于 OpenAI 官方发布与公开评测,解读 GPT Images 2.6——延续 Flare/Sunburst 双变体:生成提速 50%(Flare 低画质档最快 6 秒)、原生动图 GIF(16 帧与静态图同价)、Markup 标注编辑、SVG 矢量导出,价格不变。AA 双榜登顶。公开实测 8 组对比:SOTA 仍会在透视翻车,日常首选 Flare。附 QuickRouter 实时价格与国内直连接入代码。

GPT-6.1 Terra 评测:排名比 Kimi 高,但更高的排名不等于更全能
基于 OpenAI 官方发布与公开评测,解读 GPT-6.1 Terra——GPT-6.1 家族的中档主力:$1/$5 定价、Agents' Last Exam 60.0% 反超 Kimi K3.1 Pro、MMMU-Pro 85.5% 同级首个破 85、幻觉率暴降、三倍执行速度、家族唯一支持零思考秒回。公开实测:多模态推理胜 Kimi,但 3D 与复杂创意全面落败——高频自动化之选,非全能选手。附 QuickRouter 实时价格与国内直连接入代码。

Kimi K3.1 Pro 评测:99 天 RL 重炼,Terminal-Bench 65.7% 咬住 Opus 5.5
基于 Moonshot 官方发布与公开评测,解读 Kimi K3.1 Pro——K3 的 2.8T 骨架 + 99 天 RL 后训练:Terminal-Bench 4.0 65.7%、SWE-Marathon 51.7%、DeepSWE 75.5% 多项第一,幻觉率 23.4% 砍到 8.3%,API 降价三分之一至 $2/$10 并开源权重。公开实测:3D 与前端视觉惊艳、力压 GPT-6 Astra。附 QuickRouter 实时价格与国内直连接入代码。